Jevは、TypeSafe AIが開発した、ソフトウェア内の判断や分類に使うAIモデルです。長い文章を作るよりも、「どのカテゴリか」「基準にどの程度合うか」といった問いに、プログラムで扱える値を返すことを目的にしています。出典:TypeSafe AI公式ドキュメント
公式発表ページの日付は2026年9月15日です。同社はJevを最初の公開System One Modelとして、早期アクセスで提供すると発表しました。この記事では公式資料を基に、LLMとの違い、料金、試し方、ブログ運営への活用例を整理します。APIを実行したレビューではありません。出典:Jevの発表
- Jevは、分類や評価をアプリへ組み込みたい人向けのモデルです。
- 型の正しさは、判断内容が必ず正しいことを意味しません。
- 速度やコストの優位性は、対象の仕事と測定条件を確認して判断します。
1. Jevとは?「文章を書くAI」と何が違うのか
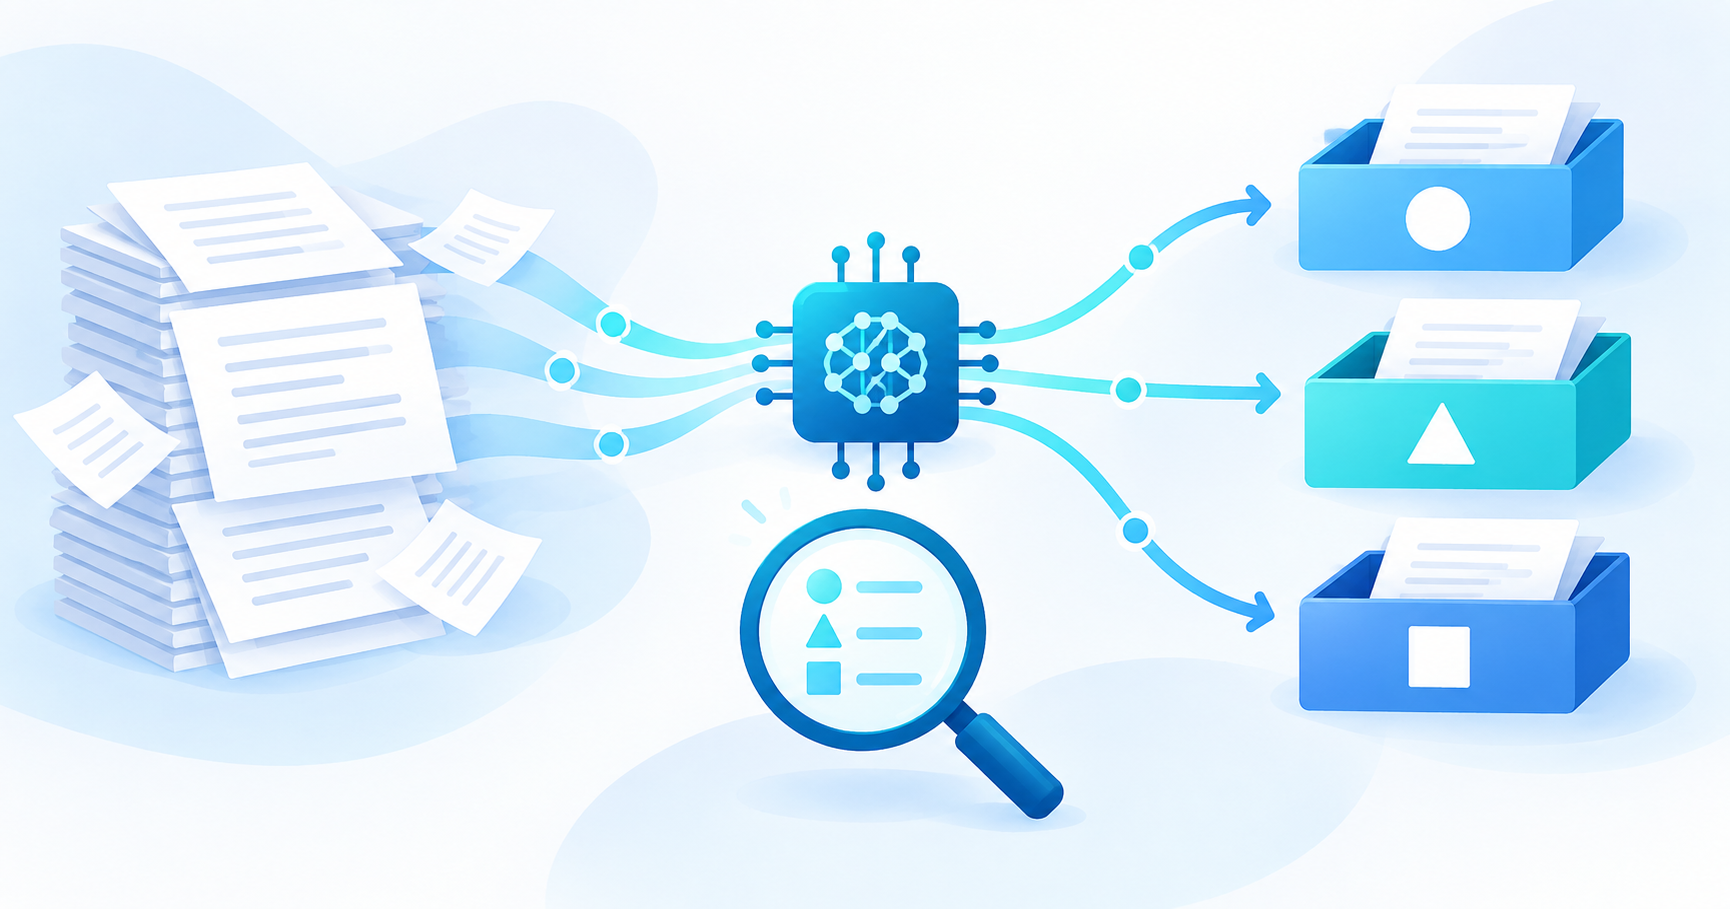
TypeSafe AIは、素早い構造化された判断のためのモデル群をSystem One Modelsと呼んでいます。これは同社の呼称です。Jevには判断材料であるstateと、何を判定するかを定義したquestionsを渡します。
公式ドキュメントにある基本の質問型は次の3つです。複数の質問を同じ入力に対して評価できます。出典:Introduction
| 質問型 | 目的 | ブログを題材にした問いの例 |
|---|---|---|
| Choice | 候補から選ぶ | 記事は「使い方・比較・ニュース・その他」のどれか |
| Score | 用意した評価基準で点数化する | 手順説明がどの程度具体的か |
| Noul | 命題が真である確率を0〜1で返す | この記事には料金についての記述があるか |
例えば「この記事を解説して」という依頼は、読者向けの文章を求めています。一方、「この記事は比較記事か」という問いは、記事一覧を分類する処理に使えます。Jevを理解するには、AIへの依頼を文章の作成と、決められた項目の評価に分けて考えると分かりやすいでしょう。
ただし、LLMでも構造化出力を扱うことはできます。「LLMはJSONを返せないからJevが必要」という比較は適切ではありません。Jevの特徴は、判断向けの出力を中心に設計されている点です。TypeSafe自身の発表にも、既存LLMを構造化判断向けに制約した比較条件が記載されています。出典:比較実験の説明
2. 料金と速度は? 公表値の読み方
TypeSafe AIの発表では、入力100万トークンあたり0.042米ドル、出力は無料とされています。単純計算では、課金対象の入力が合計100万トークンなら入力分は0.042米ドルです。本文の文字数だけでなく質問や条件も含め、実際の使用量と課金条件を確認してください。出典:提供元の料金説明
Vercel AI GatewayにもJevのモデルページがあります。経由サービスによって表示や課金条件が異なる可能性があるため、利用する入口の最新条件を確認します。出典:VercelのJevモデルページ
TypeSafeのトップページには、特定のワークフローで193.6倍速い・444.6倍安いという比較が掲げられています。これは提供元の評価値で、すべてのAI作業に当てはまる倍率ではありません。出典:TypeSafe AI
発表では、比較に使った参照値が他モデルの予測に基づくことや、改善倍率が実利用で得られる範囲の上側になり得ることも説明されています。人が正解を確認した自社データでの精度と、同じ意味で受け取らないようにしましょう。出典:Workflow evalsの補足
導入を判断するなら、「1件の呼び出しが安いか」だけでなく、間違った分類を直す時間も含めて比べます。月に数件の作業なら手作業で十分でも、同じ基準で大量の記事や問い合わせを仕分けるなら、検証する価値が出てきます。
3. Jevの試し方:まずはPlaygroundで小さく確認
公式サイトは早期アクセス・ウェイトリストを案内しています。利用権がある場合、公式Quick startではTypeSafeのPlaygroundへログインし、stateにテキストを入れて質問を追加する手順が紹介されています。検索で見つかるJev名義の紹介サイトやデモを、提供元の公式サイトと混同しないようにしましょう。出典:公式Quick start
- 実データの代わりに、短い架空の記事要約を用意する。
- 「記事の主な目的はどれか」という質問を1つ作る。
- 候補ごとの意味を定義し、「その他・判断困難」も用意する。
- 自分の判定と照合し、曖昧な例でどう変わるかを確認する。
APIではPOST https://api.typesafe.ai/v1/systemoneを使い、APIキーで認証します。以下は公式の形式を参考に、本記事用に作成したリクエスト本文例です。実行結果や、精度を保証するサンプルではありません。
{
  "model": "jev-latest",
  "state": "この記事は、学習記録アプリで利用者と記録の関係を整理する手順を説明する。",
  "questions": {
    "article_kind": {
      "type": "choice",
      "instructions": "記事の主な目的に最も合う分類を選ぶ。材料不足や複数分類が同程度ならotherを選ぶ。",
      "criteria": {
        "how_to": "読者が作業するための方法や手順を説明する",
        "comparison": "複数の選択肢を比較する",
        "news": "新しい出来事や発表を伝える",
        "other": "その他、または材料不足で分類を決められない"
      }
    }
  }
}APIキーは公開記事やブラウザへ配るコードに埋め込まず、サーバー側で扱います。PythonやTypeScript向けの導入方法は、公式Quick startで現在の記法を確認してください。
4. 「ハルシネーションゼロ」でも判断の検証は必要
TypeSafeは型安全性を強調しています。しかし、指定したカテゴリ名しか返さなくても、内容に合わないカテゴリを選ぶことは別の問題です。例えば、正しい形式でnewsと返っても、実際は手順記事かもしれません。出力の形式と、内容の正誤を別々に確認する必要があります。
公式Confidenceドキュメントでは、ChoiceとScoreのconfidenceは、選択肢や評価段階の確率分布から計算する指標と説明されています。Noulには同じconfidence項目はありません。したがって「confidenceが0.9だから、自分の用途でも必ず90%正解する」とは解釈しません。出典:Confidence
実際の分類では、人が判定した例を用意して、どの種類の記事で間違えやすいかを確認します。確認待ちへ回す基準は、判断を間違えたときの影響に合わせます。削除・公開・送金などを、モデルの高いスコアだけで許可する仕組みにはしない方がよいでしょう。
また、質問を増やすときは、答え同士の依存関係に注意します。公式ドキュメントでは、各質問は同じstateに対して独立して評価されるとされています。「最初の質問の答えを使って次を判断したい」場合は、処理を分ける設計を考えます。出典:質問の評価方法
AIへ渡す情報や連携権限の整理は、AI時代のセキュリティ対策でも解説しています。
5. ブログ運営ならどう使う? 小さな検証の進め方
このブログで試すなら、最初の候補は既存記事の分類案を作ることです。これは本記事での活用提案で、Jevを導入してPVが増えたという実績ではありません。
| 段階 | 行うこと |
|---|---|
| 正解例を用意する | 公開済みの記事から、明確な例と曖昧な例を混ぜて人が分類する |
| 基準を揃える | 「使い方」「比較」「ニュース」などの境界を短く説明する |
| 提案だけを出す | Jevの分類案と確率を保存し、WordPressは更新しない |
| 誤りを確認する | 人の判定との差と確認にかかった時間を記録する |
| 別の記事でも試す | 基準づくりに使わなかった記事で、同じ傾向が続くかを見る |
要約だけでは判別できない記事もあるため、必要な本文を渡した場合と比べます。逆に、投稿日の条件や数値の大小だけで決められる処理は、通常のコードで行う方が明確です。AIを使う場所を「文章の意味を読まないと決めにくいところ」に絞ります。
分類が整理されれば、関連記事候補を探す準備には使えます。ただし、カテゴリが一致するだけで読者に役立つリンクになるとは限りません。最後に内容を確認し、読者が次に知りたいことへつなげる判断が必要です。
こうした分類機能を学習アプリへ組み込むなら、入力・出力・人が確認する状態を先に決めておくと設計しやすくなります。ER図とデータ設計の考え方も参考になります。
Jevは、文章を書くAIを使い始めた人全員に必要な道具ではありません。同じ基準で繰り返す判断をプログラムに組み込みたいとき、手作業や既存の方法と比較する候補として捉えると、試す目的が明確になります。
複数の開発・調査タスクの進行管理については、Claude Codeの新Projectsとは?使い方・対象プラン・使用量の注意点も参考にしてください。
情報確認日:2026年9月18日。料金・提供条件は利用時に公式情報を確認してください。公表値と独自の活用提案を分けて記載しており、APIの実測や日本語精度の検証は行っていません。